취향 컴파일러
생성 시스템을 위한 실시간 취향 추론을 어떻게 만들 것인가
영어 원문에서 옮김 · 기계 초벌 번역, 검수 전
취향 모델 연작의 2부. 1부는 스칼라 보상이 봉우리를 납작하게 만든다고 주장했다. 이 글은 그 대안을 짓는다.
음악 생성기에 프롬프트를 넣는다. 클립 여덟 개가 돌아온다. 대부분 유능하고 평범하게 들린다. 성긴 피아노 편곡에 절제된 드럼이 깔린 것을 고른다. “리버브 덜, 저음은 더 타이트하게”라고 친다. 다음 묶음이 도착한다. 더 가까워졌다. 다시 고르고, 다시 편집한다. 두 라운드 더. 나온 것은 수백만 쌍의 선호로 학습된 모델이 “좋은 음악”이라 여기는 소리가 아니라, 당신에게 실력이 있었다면 만들었을 법한 소리로 들린다.
방금 무언가가 당신의 취향을 생성기가 쓸 수 있는 형태로 컴파일했다. 기술한 것이 아니다. 점수를 매긴 것이 아니다. 컴파일했다. 번역자가 말을 하면서 언어를 배우듯, 주고받을 때마다 번역이 다듬어지고 번역은 늘 잠정적인 방식으로. 1부는 이 컴파일러가 모든 주요 생성 시스템에 빠져 있다고, 현재의 접근은 취향을 스칼라 보상으로 납작하게 만들고, 모집단의 중간값에 최적화하며, 창작 결과물을 아낄 만하게 만드는 개인의 봉우리를 씻어 낸다고 주장했다. 이 글은 그 컴파일러를 짓는다.
1. 취향 컴파일러로 합쳐지는 다섯 아이디어
이 모델은 다섯 아이디어 위에 선다. 각각은 기존 시스템이 무시하는 취향의 속성 하나에 응답한다.
- 취향을 안정적인 특성과 변덕스러운 세션 상태로 나눈다
- 맥락에 조건 지어진 이중선형 효용으로 후보를 채점한다
- 선택, 편집, 이유 설명, 거부에서 따로따로 배운다
- 2차 곡률을 자연스러운 정보성 비중으로 삼아 믿음을 온라인으로 갱신한다
- 기대 정보 이득을 최대화하도록 다음에 보여 줄 것을 고른다
취향에는 안정적인 성분과 변덕스러운 성분이 있고, 학습률 하나로 된 임베딩 하나로는 영구적 이동과 스쳐 가는 기분을 구별할 수 없다. 그래서 첫 수는 분해된 취향 상태 z = z_trait + z_state다. z_trait는 세션을 가로질러 천천히 갱신되는 안정적 선호를 담고, z_state는 세션 안에서 빠르게 갱신되는 현재의 의도를 담는다.
취향 상태는 효용 함수가 사용자가 어떤 상황에 있는지 알 때만 쓸모 있다. 코딩할 때 배경 음악의 취향은 저녁 모임 음악의 취향이 아니다. 이것이 명시적 맥락 조건화를 가진 이중선형 효용의 동기다. u(x) = z⊤ h_φ(x, c, y). 같은 후보 x가 맥락에 따라 다른 표현을 낳는다. 취향은 특징 공간의 방향이 되고, 맥락은 상황마다 별도의 취향 벡터를 요구하는 대신 표현을 통해 들어온다.
사용자는 고르기만 하지 않는다. 편집하고, 설명하고, 거부하며, 신호 유형마다 다른 정보를 실어 나른다. 다중 신호 추론은 피드백 유형마다 별개의 경로를 주어, 신호 유형에 따라 취향 벡터 z, 그 불확실성, 또는 표현 h_φ를 갱신한다.
모든 선택이 똑같이 정보적이지도 않다. 2차 곡률을 쓰는 베이즈 온라인 갱신은 사후 분포가 관측을 그 정보성에 따라 자연스럽게 가중하게 한다. 확신에 찬 선택은 큰 헤시안을 낳아 추정치를 크게 움직인다. 미지근한 선택은 거의 기록되지 않는다. 사후 공분산은 다음에 무엇을 보여 줄지도 시스템에 알려 준다.
마지막으로, 선택 사건은 후보가 잘 골라졌을 때만 정보적이다. 같은 모드의 변형 여덟 개를 생성하면 사용자의 선택은 거의 아무것도 말해 주지 않는다. 정보 이론적 포트폴리오 선택은 사용자 취향에 대한 기대 정보 이득을 최대화하는 후보 집합을 구성한다. 이것이 1부가 진단한 안전한 중간값으로의 붕괴를 막는다.
이들이 합쳐져 하나의 루프를 이룬다. 이 글의 나머지는 모든 구성 요소를 명세한다.
2. 전체 파이프라인: 한 라운드 안에서 생성부터 학습까지
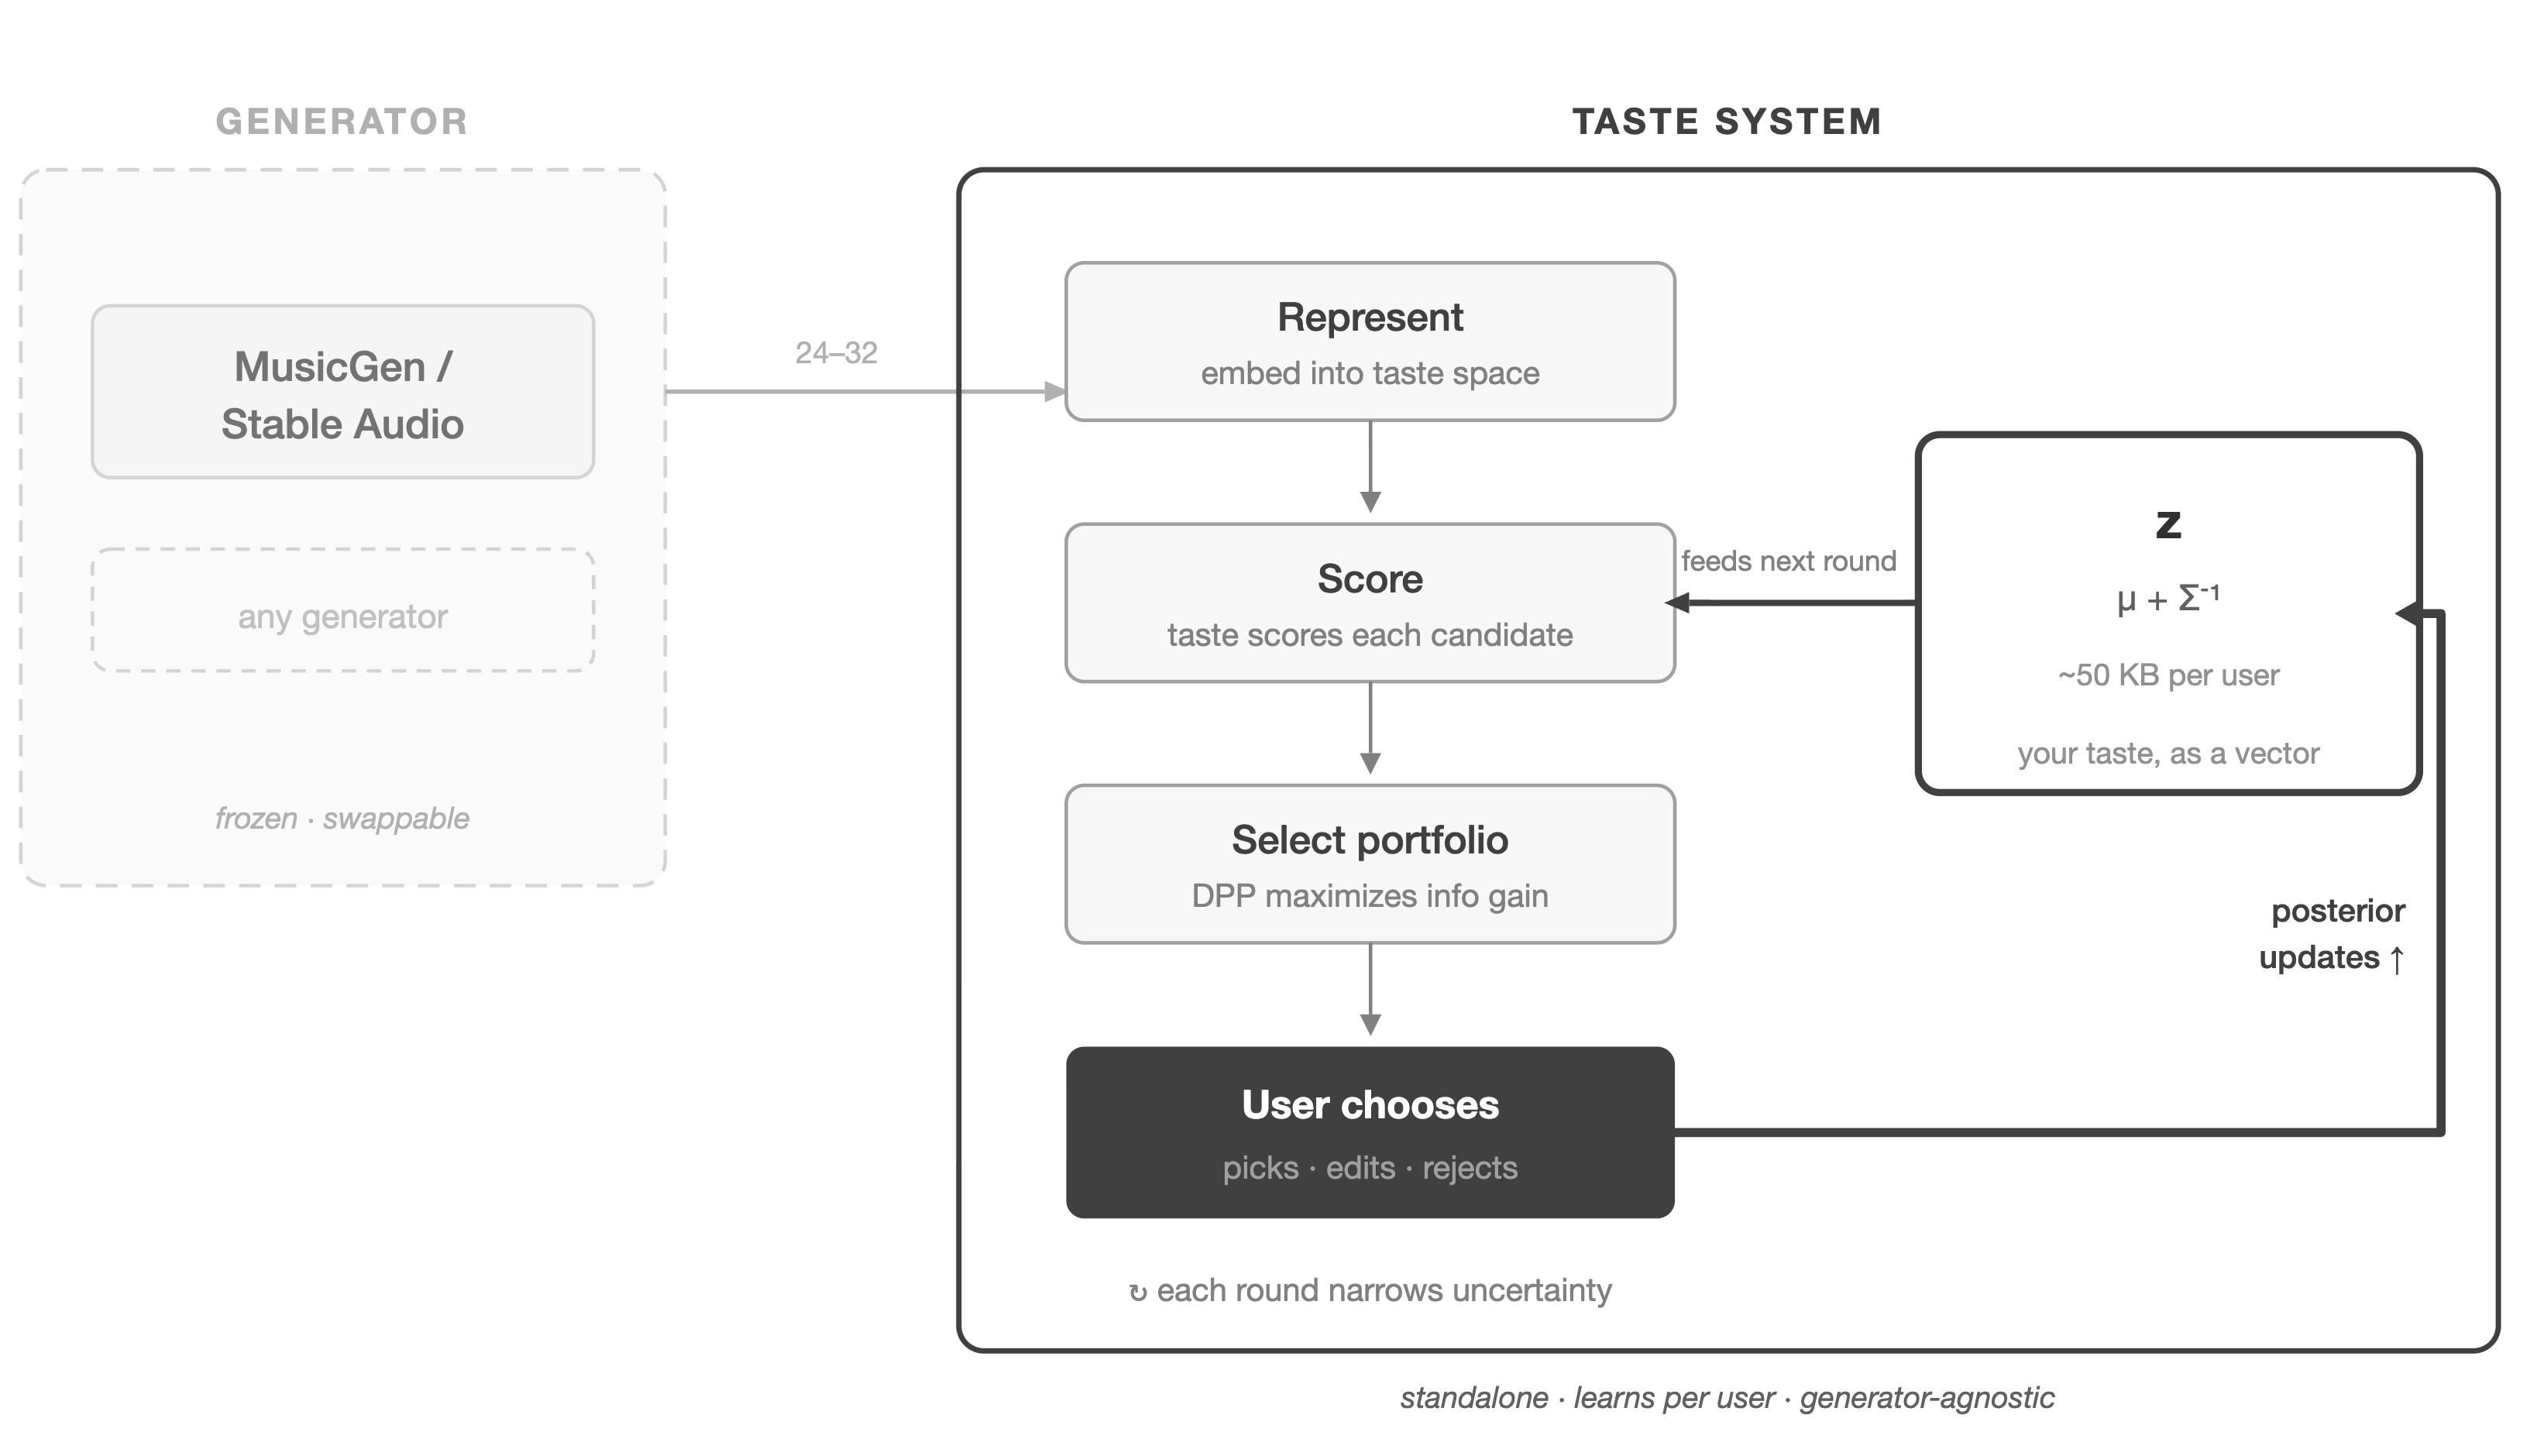
전체 파이프라인은 이렇다. 각 구성 요소는 등장하는 순간에 명세한다.
후보 풀. 루프는 MusicGen(또는 Stable Audio Open)에서 나온 N=24-32개의 후보 클립으로 시작한다. 다양성은 설계해서 만들어야 한다. 같은 프롬프트에 무작위 시드만 바꾸면 사소한 확률적 변이만 나오기 때문이다. 풀은 세 가지 변이의 원천을 대략 같은 비율로 합친다. 표면적 질감의 다양성을 위한 서로 다른 무작위 시드, 취향과 관련된 축을 따른 체계적 프롬프트 증강(기본 프롬프트에 “성긴 편곡”, “빽빽하게 겹친”, “따뜻한 아날로그”, “밝은 디지털”, “드라이한 근접 마이킹”, “앰비언트 리버브” 같은 스타일 수식어를 덧붙이기), 그리고 가이던스 스케일 변이(낮은 스케일은 더 놀라운 결과를, 높은 스케일은 프롬프트에 더 가까운 결과를 낸다). 이것이 프로덕션 스타일, 편곡 밀도, 음색 성격에 걸친 진짜 퍼짐을 만든다.
표현. 각 후보는 (오디오, 맥락, 프롬프트)를 취향 공간 ℝ^d로 대응시키는 표현 네트워크 h_φ를 거친다. d=64다. 왜 64인가. 투영 뒤 CLAP 임베딩 공간의 주된 변이 축을 담을 만큼 크고, 관측이 드문 초기 라운드에서 정밀도 행렬 Σ^{-1}이 좋은 조건을 유지할 만큼 작다. 고정된 CLAP 오디오 인코더가 512차원 임베딩 e_audio를 만든다. CLAP의 텍스트 인코더가 프롬프트에서 e_text를 만든다. 맥락 c(“집중”이나 “사교” 같은 범주 태그, 또는 자유 텍스트 기술)는 학습된 임베딩이나 같은 텍스트 인코더로 부호화되어 e_context를 만든다. 이 세 벡터를 이어 붙인 1536차원 입력이 2층 MLP(1536 → 256 → d, ReLU 활성화)를 거친다. MLP가 유일하게 학습되는 구성 요소다. 인코더는 고정된 채로 두어, 사용자별 작은 데이터셋으로도 시스템을 학습할 수 있게 한다.
주의할 점. CLAP은 취향에 중요한 프로덕션 수준의 구별(리버브의 성격, 스테레오 폭, 컴프레션 스타일)이 아니라 일반 오디오로 학습되었다. 고정된 인코더는 지각적으로 구별되는 후보들을 가까운 임베딩으로 뭉갤 수 있다. h_φ MLP가 부분적으로 보상할 수 있지만, 더 나은 음악 특화 인코더가 나오면 가장 먼저 교체가 필요할 구성 요소다.
각 후보의 효용은 이중선형 형식이다.
u(x) = z⊤ h_φ(x, c, y)
취향 벡터 z는 특징 공간의 방향을 정의하고(τ와 사전 분포가 정하는 크기까지), 효용은 각 후보의 표현과의 내적이다. 사전 분포는 z ~ N(0, λ^{-1}I)이며, λ는 효용의 크기를 τ에 상대적으로 O(1)로 유지하도록 고른다. τ를 전역적으로 고정하고 ‖z‖를 사전 분포로 정칙화해, 선택 온도와 취향 크기 사이의 퇴화를 피한다. 맥락의 이동은 맥락별 취향 벡터 없이 표현이 처리한다.
포트폴리오 선택. 부호화된 N개의 후보에서 시스템은 보여 줄 K=6-8개를 고른다. 선택은 z에 대한 기대 정보 이득을 최대화한다.
I(z; 선택 | {x_1,…,x_K}) = H[선택 | {x_1,…,x_K}] − E_z[H[선택 | z, {x_1,…,x_K}]]
부분집합에 대한 정확한 상호 정보 최대화는 조합적이다. 커널 K_ij = q_i · h_φ(x_i)⊤h_φ(x_j) · q_j, q_i = exp(μ_t⊤h_φ(x_i))인 품질 가중 DPP로 근사한다. DPP는 특징 공간을 넓게 아우르되 효용이 높은 영역으로 기울어진 부분집합을 고른다. 32×32 커널에서의 정확한 샘플링은 상호작용에 쓸 만큼 싸다. DPP가 고른 후보 가운데 시스템은 사후 효용 분산 Var_z[u(x)] = h_φ(x)⊤ Σ_t h_φ(x)가 큰 것, 곧 시스템이 가장 불확실한 지점을 우선한다. 한두 자리는 기대 효용 μ_t⊤h_φ(x)가 높은 후보에 남겨 두어, 사용자가 탐색과 나란히 수렴도 보게 한다. 초기 라운드(큰 tr(Σ_t))는 다양성을 선호한다. 후기 라운드는 봉우리 찾기로 옮겨 간다. 단순한 스케줄은 floor(K · min(1, tr(Σ_t)/tr(Σ_0)))개의 자리를 탐색에 배분한다. 이는 불확실성 질량의 휴리스틱 대리 지표이며, 사후 엔트로피의 어떤 단조 함수든 비슷하게 작동한다.
DPP 커널은 h_φ 공간의 내적이 지각적 유사도에 대응한다고 가정한다. 표현에 맹점이 있으면(있을 것이다. 위의 CLAP 주의 참조) DPP는 임베딩에서는 다양해 보이지만 사용자에게는 비슷하게 들리는 후보를 고를 수 있다. 포트폴리오에서 사용자가 느끼는 중복을 모니터링해 신호로 되먹이는 일은 열린 설계 문제다.
“앰비언트 피아노” 프롬프트의 1라운드 포트폴리오는 이런 것들을 담을 수 있다. 성기고 리버브가 짙은 테이크, 드라이한 근접 마이킹 버전, 빽빽하게 겹친 편곡, 두 음짜리 최소 모티프, 따뜻한 아날로그 처리 클립, 서브베이스가 두드러진 것 하나. 이 퍼짐에서의 사용자 선택은 후보들이 h_φ 공간에서 멀리 떨어져 있기에 큰 그래디언트를 낳는다.
사용자가 응답한다. 사용자는 후보 하나를 고르고, 선택적으로 편집하거나 선택을 설명하거나, 전부 거부한다. 선택 모델은 다항 로짓으로, 쌍별 비교로 줄이지 않고 K개 전체의 선택 집합을 우도에 쓴다.
P(x_i 선택 | z, {x_1,…,x_K}, c, y) = exp(u(x_i) / τ) / Σ_j exp(u(x_j) / τ)
온도 τ는 선택의 날카로움을 조절하며, 응답 시간과 숙고 패턴 같은 행동 신호로 사건마다 추론할 수 있다. 빠르고 단호한 선택은 낮은 τ를, 머뭇거린 선택은 높은 τ를 뜻한다.
사후 분포는 어떻게 갱신되는가. z에 대한 사후 분포의 가우시안 근사를 유지하고, 로짓 우도의 그래디언트와 곡률로 온라인 갱신한다. p_j = exp(u(x_j)/τ) / Σ_k exp(u(x_k)/τ)를 예측된 선택 확률, h_j = h_φ(x_j)를 후보 표현이라 하자. 소프트맥스 로그 우도의 그래디언트와 헤시안은 닫힌 형식을 가진다.
∇_z log P(x_i 선택 | z) = (1/τ)(h_i − Σ_j p_j h_j)
∇²_z log P(x_i 선택 | z) = −(1/τ²)(Σ_j p_j h_j h_j⊤ − (Σ_j p_j h_j)(Σ_j p_j h_j)⊤)
그래디언트는 고른 후보의 표현과 확률 가중 평균의 차이, 곧 “놀람”의 방향이다. 헤시안은 표현들의 확률 가중 공분산에 음의 부호를 붙인 것이다. 사후 갱신은 이렇다.
μ_{t+1} = μ_t + Σ_t · (1/τ)(h_i − Σ_j p_j h_j)
Σ_{t+1}^{-1} = Σ_t^{-1} + (1/τ²)(Σ_j p_j h_j h_j⊤ − (Σ_j p_j h_j)(Σ_j p_j h_j)⊤)
d=64에서 이는 라운드마다 작은 2차 갱신이며(64×64 정밀도 행렬, 사용자당 대략 50KB), 최적화 루프도 생성기를 통한 역전파도 없다. 헤시안이 정보의 비대칭을 자동으로 강제한다. 확신에 찬 선택은 큰 헤시안을 낳아 사후 분포를 크게 좁힌다. 미지근한 선택은 거의 기록되지 않는다.
여기서 위험 하나는, 제시된 h 벡터들이 낮은 랭크의 부분 공간에 몰리면(포트폴리오에 진짜 다양성이 없을 때 일어난다) 곡률 갱신의 조건이 나빠진다는 것이다. 실제로 이는 포트폴리오 선택 단계가 갱신 단계를 떠받친다는 뜻이다. 허술하게 다양화된 포트폴리오는 사용자의 주의를 낭비하는 데 그치지 않는다. 사후 분포를 오염시킬 수 있다.
보조 신호. 사용자가 더 풍부한 피드백을 주면 추가 경로가 활성화된다.
편집. 사용자가 편집을 기술한다(“리버브 덜”). 시스템은 편집 지시를 덧붙인 수정 프롬프트로, 무관한 변이를 최소화하기 위해 같은 무작위 시드를 써서 재생성한다. 편집 방향 Δ = h_φ(x_i’) − h_φ(x_i)는 어느 특징을 따라 움직일지에 대한 직접 신호다. 손실 L_edit = −z⊤Δ / (‖z‖ ‖Δ‖)는 z를 그 방향에 정렬되도록 당긴다. 시드 일치가 결정적이다. 그것이 없으면 확률적 재생성 변이가 편집 신호를 익사시킨다. 생성기가 시드에 안정적으로 조건 지어지지 않으면, 짝지은 변형을 여럿 생성해 Δ를 평균 내는 것으로 근사한다. 편집 하나는 전체 후보의 순위가 아니라 특정 축을 짚기 때문에, 순수 선택 두세 라운드의 값어치가 있다.
이유 설명. 텍스트 이유 설명은 텍스트 인코더로 임베딩 r에 부호화된다. 대조 손실 L_rationale = −log [exp(sim(h_φ(x_selected), r)) / Σ_j exp(sim(h_φ(x_j), r))]가 h_φ의 특징 공간을 빚어, 사용자들을 가로질러 점점 더 취향과 관련되게 만든다. MLP는 이 그래디언트를 쌓아 두었다가 야간 배치 일정으로 갱신하고, z는 실시간으로 갱신된다.
거부. 전부 거부하면 사후 분포가 부푼다. Σ_{t+1} = Σ_t + σ²_reject · I. 다음 라운드는 넓게 탐색해야 한다는 신호다.
세션 간 지속. 세션 안에서 모든 갱신은 z_state를 겨냥한다. 세션을 가로질러 z_trait는 혼합 규칙으로 세션의 증거를 흡수한다.
μ_trait ← (1 − α_trait) μ_trait + α_trait · μ̄_state^(session)
Σ_trait^{-1} ← (1 − β_trait) Σ_trait^{-1} + β_trait · Σ̄_state^{-1 (session)}
여기서 α_trait ≈ 0.01-0.05이고 β_trait는 특성 수준의 확신이 얼마나 빨리 자라는지를 조절한다. z_trait는 사용자마다 (μ, Σ^{-1}) 쌍으로 저장된다. 새 세션이 시작될 때마다 z_state는 z_trait에서 초기화되어 거기서부터 적응한다.
지연. 사용자가 현재 포트폴리오를 평가하는 동안 시스템은 다음 후보 풀을 미리 생성한다. 사용자가 응답하면 사후 분포는 마이크로초 안에 갱신되고, 포트폴리오 선택은 새 μ와 Σ로 미리 생성된 풀 위에서 다시 돌며, 다음 라운드는 체감 대기 시간이 거의 0인 채로 나타난다.
루프의 실제 동작. 1라운드에서 최대의 Σ_0은 DPP가 지배하고 포트폴리오가 스타일 공간을 넓게 아우른다는 뜻이다. 멀리 떨어진 후보들 중의 선택 하나가 큰 헤시안을 낳아 사후 분포를 크게 좁힌다. 3-5라운드가 되면 포트폴리오는 추정된 봉우리 근처에 모이고, 가장 불확실한 차원을 따라 흔들린다. 편집은 특정 축의 수렴을 가속한다. 사용자가 자기 패턴과 어긋나게 행동하면 z_state가 그 이동을 흡수하고 z_trait는 버틴다. 다음 포트폴리오는 두 방향을 모두 좇는 후보로 헤지한다. Σ_t의 주된 차원들이 작아지면 탐색은 직교 부분 공간으로 재배분되어, 사용자가 탐색하지 않았지만 표현이 좋아할 것이라 예측하는 후보를 띄운다. 이것이 선제적 발견이다. 보정된 불확실성이 구조화된 표현과 상호작용하며 창발한다.
3. 시스템이 함의하는 것
생성은 범용재가 되어 간다. 취향 층은 그렇지 않다. 주류 프롬프트에서 생성 품질은 MusicGen, Stable Audio, Suno, Udio에 걸쳐 수렴하고 있다. 취향 루프는 어떤 생성기 위에도 얹히며, 사용자가 실제로 느끼는 부분이다. 생성이 인프라가 될수록 취향 층이 제품 표면이 된다.
취향 데이터는 소비 데이터가 할 수 없는 방식으로 복리로 쌓인다. 추천 시스템은 고정된 카탈로그에서 당신이 무엇을 소비했는지로 배운다. 취향 루프는 반사실적 선호 데이터를 만든다. 시스템이 생성하기 전에는 존재하지 않았던 것들 가운데 당신이 무엇을 골랐는가. 이는 어떤 카탈로그에도 없는 영역의 선호를 드러내고, 플라이휠에 먹이를 준다. 더 많은 사용자가 h_φ의 표현을 개선하고, 그것이 새 사용자의 취향 추론을 가속한다. 취향 층은 생성기와 분리할 수도 있어서, 사용자의 z_trait가 도구와 양식을 가로질러 여행할 수 있다.
취향 축 설계에 도메인 전문성이 산다. 음악 대 이미지에 맞는 프롬프트 증강 축은 무엇인가? 어떤 지각 차원이 사람의 선호를 가르며, 그것을 ℝ^d에 어떻게 대응시켜야 하는가? 정보 이득을 최대화하는 콜드 스타트 온보딩을 어떻게 설계하는가? 이 질문들은 표현 학습의 유창함과 결합된 도메인 전문성을 요구한다. 생성기가 나아질수록 이 일은 더 중요해진다. 더 풍부한 출력 공간에는 더 정교한 항해가 필요하기 때문이다.
가장 중요한 실패 양상은 조용한 표류다. 선호를 잘못 배운 취향 모델은 이후의 모든 라운드를 망친다. z_trait가 잘못 표류하면 포트폴리오를 오염시키고, 그것이 더 나쁜 선택을 낳고, 그것이 표류를 강화한다. 시스템에는 보정 모니터링, 표류 감지, 우아한 복구가 처음부터 설계되어 있어야 한다.
4. 열린 문제와 어디서 시작할 것인가
수렴 속도. z가 무작위 포트폴리오를 능가하기까지 몇 라운드가 걸리는가? 가설: 음악은 3-5라운드(d=64, K=8), 이미지는 5-10라운드. 라운드 수의 함수로서의 보류 선택 예측으로 측정할 수 있다.
탐색 예산. 위의 탐색-활용 스케줄은 휴리스틱이다. 누적 후회에 대한 베이즈 최적화 문헌이 이론적 도구를 주지만, 창작 환경에서의 경험적 질문은 연구되지 않았다.
신호 희소성. 대부분의 사용자는 클릭만 할 것이다. 편집이나 이유 설명 없이 성능은 어떤 곡선으로 떨어지는가? 절제 실험으로 측정할 수 있다.
취향 표류. 몇 주 떨어진 세션 사이에서 z_trait는 어떻게 갱신되어야 하는가? z_state와 z_trait 사이의 KL 발산을 모니터링하다가 발산이 클 때 더 빠른 혼합을 촉발하는 변화점 감지 층이 단순한 감쇠보다 나을 수 있다.
h_φ 콜드 스타트. h_φ의 특징 공간이 취향과 관련된 축에 정렬되려면 시스템이 몇 명의 사용자를 봐야 하는가?
내가 먼저 돌릴 실험은 MusicGen이나 Stable Audio Open을 쓴 음악 생성이다. 참가자 30-50명, 5-8세션에 걸쳐, 무작위 포트폴리오, 선택만의 학습, 완전한 다중 신호 학습을 스칼라 RLHF와 협업 필터링 기준선과 비교한다. 핵심 지표는 수렴 속도, 보류 취향 예측(보지 못한 집합에서의 top-1/top-3), 승인된 결과물 사이의 다양성이다.
각각 논문 한 편 값어치가 있는 세 문제:
표현 학습. 기준선으로서 고정 CLAP에 선형 투영 대 파인튜닝 대 처음부터 학습을 라운드별 예측 정확도로 잰다. 가설: 파인튜닝이 더 빨리 수렴하며, 격차는 1-3라운드에서 가장 크다.
스케일링 법칙. 수렴은 d, K, 모집단 다양성에 따라 어떻게 변하는가? 정보 이론적 논증은 최선의 경우 O(d / log K) 라운드를 시사한다. 이 한계에 대한 경험적 측정은 취향 추론을 비율 왜곡 이론에 잇는다.
교차 양식 전이. 음악에서 배운 z가 이미지 선호를 예측하는가? 같은 사용자를 MusicGen과 Stable Diffusion에 걸쳐(Pick-a-Pic 또는 HPD v2로 평가). 두 z 벡터 사이의 정준 상관 분석.
빌더를 위해. 생성에는 MusicGen, h_φ에는 고정 CLAP에 2층 MLP, 사건별 τ를 쓴 소프트맥스, 닫힌 형식 헤시안을 쓴 온라인 가우시안 갱신, 프롬프트 증강과 시드/가이던스 변이로 만든 24-32개 후보에서의 DPP 포트폴리오 선택. z_trait는 사용자마다 (μ, Σ^{-1})로 저장한다. 사용자가 현재 라운드를 평가하는 동안 다음 풀을 미리 생성한다. 첫 버전이 보여 줘야 할 것은 하나다. 취향에 조건 지어진 포트폴리오가 무작위보다 빨리 수렴한다는 것.
내일 이것을 시작한다면 나는 루프를 닫는 가장 단순한 버전을 짓겠다. MusicGen, 고정 CLAP, 소프트맥스 선택, 온라인 가우시안 갱신, DPP 포트폴리오. 편집 없음, 이유 설명 없음, 세션 간 지속 없음. 질문 하나. 취향에 조건 지어진 포트폴리오가 무작위보다 빨리 수렴하는가? 그렇다면 이 글의 나머지는 전부 엔지니어링이다. 아니라면 표현이 틀린 것이고 다른 무엇도 중요하지 않다.
이것은 음악 너머에서 중요하다. 이미지 생성기, 비디오 생성기, 코드 생성기가 모두 같은 문제로 수렴하고 있다. 출력 품질은 누구든 자기가 실제로 원하는 것을 말하는 능력보다 빨리 나아지고 있다. 생성 쪽에는 수십억 달러의 자금과 수천 명의 연구자가 있다. 취향 쪽에는 거의 아무도 없다. 그 비대칭은 오래가지 않을 것이다. 생성이 범용 인프라가 되는 순간, 방어할 수 있는 유일한 층은 지금 이 사람을 위해 무엇을 생성할지 아는 층이기 때문이다. 그 층을 짓는 이가 창작 스택 전체의 인터페이스를 소유한다.
참고문헌
Christiano et al. (2017). Deep Reinforcement Learning from Human Preferences. 이 연구가 출발점으로 삼되 벗어나는 기초적 RLHF 프레임워크.
Luce, R.D. (1959). Individual Choice Behavior: A Theoretical Analysis.
McFadden, D. (1973). Conditional Logit Analysis of Qualitative Choice Behavior.
Rafailov et al. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 선호 정렬의 현재 지배적 접근. 우리 시스템은 DPO가 겨냥하지 않는 사용자별, 온라인, 다중 신호 환경을 다룬다.
Elizalde et al. (2023). CLAP: Learning Audio Concepts from Natural Language Supervision. h_φ의 고정 백본으로 쓰인 오디오-텍스트 인코더.
Kulesza & Taskar (2012). Determinantal Point Processes for Machine Learning.
Kirstain et al. (2023). Pick-a-Pic: An Open Dataset of User Preferences for Text-to-Image Generation.
Wu et al. (2023). Human Preference Score v2: A Solid Benchmark for Evaluating Human Preferences of Text-to-Image Synthesis.
Dumoulin et al. (2024). A Density Estimation Perspective on Learning from Pairwise Human Preferences.
Gao et al. (2024). PRELUDE: Aligning LLM Agents by Learning Latent Preference from User Edits. NeurIPS 2024.
Huang et al. (2025). MusicPrefs: A Large-Scale Dataset for Music Preference Prediction.
Tan et al. (2024). Democratizing Large Language Models via Personalized Parameter-Efficient Fine-tuning (One PEFT Per User).
Charakorn et al. (2026). Doc-to-LoRA: Learning to Instantly Internalize Contexts. Sakana AI.