발견의 구조
알파고가 사고에 관해 드러낸 것
영어 원문에서 옮김 · 기계 초벌 번역, 검수 전
보르헤스는 가능한 모든 책을 담은 도서관을 상상했다. 우리가 그것을 지었다. 대규모 언어 모델은 이제 사실상 어떤 단어의 배열이든 요청에 따라 생성하고 꺼내 올 수 있다. 완벽한 사서가 도착했다.
그런데도 발견은 자동화되지 않았다. 텍스트를 생성하는 비용은 0에 가까워진다. 진짜 통찰의 비용은 그렇지 않다. 모든 답이 이미 “그 안에” 있다면, 왜 그냥 찾아보면 안 되는가?
발견은 검색이 아니기 때문이다. 항해다. 당신은 무한히 갈라지는 나무의 한 노드에 서 있다. 각 선택은 또 다른 무한을 연다. 필요한 통찰로 가는 경로를 찾아볼 수는 없다. 그 통찰의 주소 자체가 건너뛸 수 없는 계산의 결과물이기 때문이다. 답을 일단 찾으면 검증하기는 쉽다. 찾기가 어렵다.
2012년에 나는 정확히 이런 종류의 구조를 항해하는 모델을 발표했다. 깊이와 너비에 한계가 없는 무한한 나무, 쓸모 있는 신호가 어느 한 경로에 있지 않고 위계 전체에 분산된 구조다.¹ 그 모델의 핵심 통찰은, 각 노드에서 가장 유망한 가지에 주의를 집중시키는 신호에 이끌리는 재귀적 탐색이 무한을 다룰 수 있게 만든다는 것이었다. 나는 텍스트 말뭉치의 주제 위계를 모델링하고 있었다. 같은 문제의 한 버전을 다루고 있다는 것을 깨닫지 못했다.
4년 뒤 한 시스템이 그 구조를 바둑판 위에서 보여 주었다.
1. 37수가 알았던 것
꼭 십 년 전 오늘, 세계 챔피언 이세돌과의 5번기 두 번째 대국에서 AlphaGo는 다섯째 줄에 돌을 놓았다. 해설자들은 말을 잃었다. 몇 달 동안 AlphaGo를 연구해 온 프로 기사 판후이는 말을 잇지 못했다. AlphaGo 자신의 정책 네트워크는 어떤 인간이든 그 수를 둘 확률을 10,000분의 1로 추정했다.
아름다웠다. 이기는 수였다. 그리고 진짜로 새로웠다.
이것은 검색이 아니었다. 160,000판의 인간 대국에서 뽑은 3,000만 개 국면으로 학습한 정책 네트워크는 37수를 있을 법하지 않은 수로 평가했다. AlphaGo가 인간 기보의 압축된 지식에만 기댔다면 그 수는 결코 고려되지 않았을 것이다. 무차별 탐색도 아니었다. 바둑에는 대략 10^170개의 가능한 국면이 있다. 탐색으로 답에 이를 수는 없다.
그것은 세 가지 인지 작용이 함께 일한 산물이었다.
예측. 정책 네트워크. 160,000판이 넘는 인간 대국을 다음 수에 대한 확률 분포로 압축한 것. 이 국면에서 강한 기사라면 무엇을 둘까? 대략 250개의 합법수를 그럴듯한 5개나 10개로 좁힌다. 학습된 패턴 인식이다. 무엇이 좋은지가 아니라 무엇이 있을 법한지를 말하며, 그 차이가 엄청나게 중요한 것으로 드러난다.
취향. 가치 네트워크. 국면을 보고 숫자 하나를 내놓는다. 이것은 얼마나 좋은가? 어떤 수를 둘지 말하지 않는다. 지금 있는 자리를 어떻게 느껴야 하는지를 말한다. 계산을 끝내지 않은 채 중간 상태에 방향성 있는 가치를 매긴다.
탐색. 몬테카를로 트리 탐색. 예측(어느 가지를 탐색할지)과 취향(어느 국면을 값지게 볼지)에 이끌리는, 의도적이고 순차적인 대안 탐색. 한 수마다 수천 번의 유도된 시뮬레이션. 사고에서 노동처럼 느껴지는 부분.
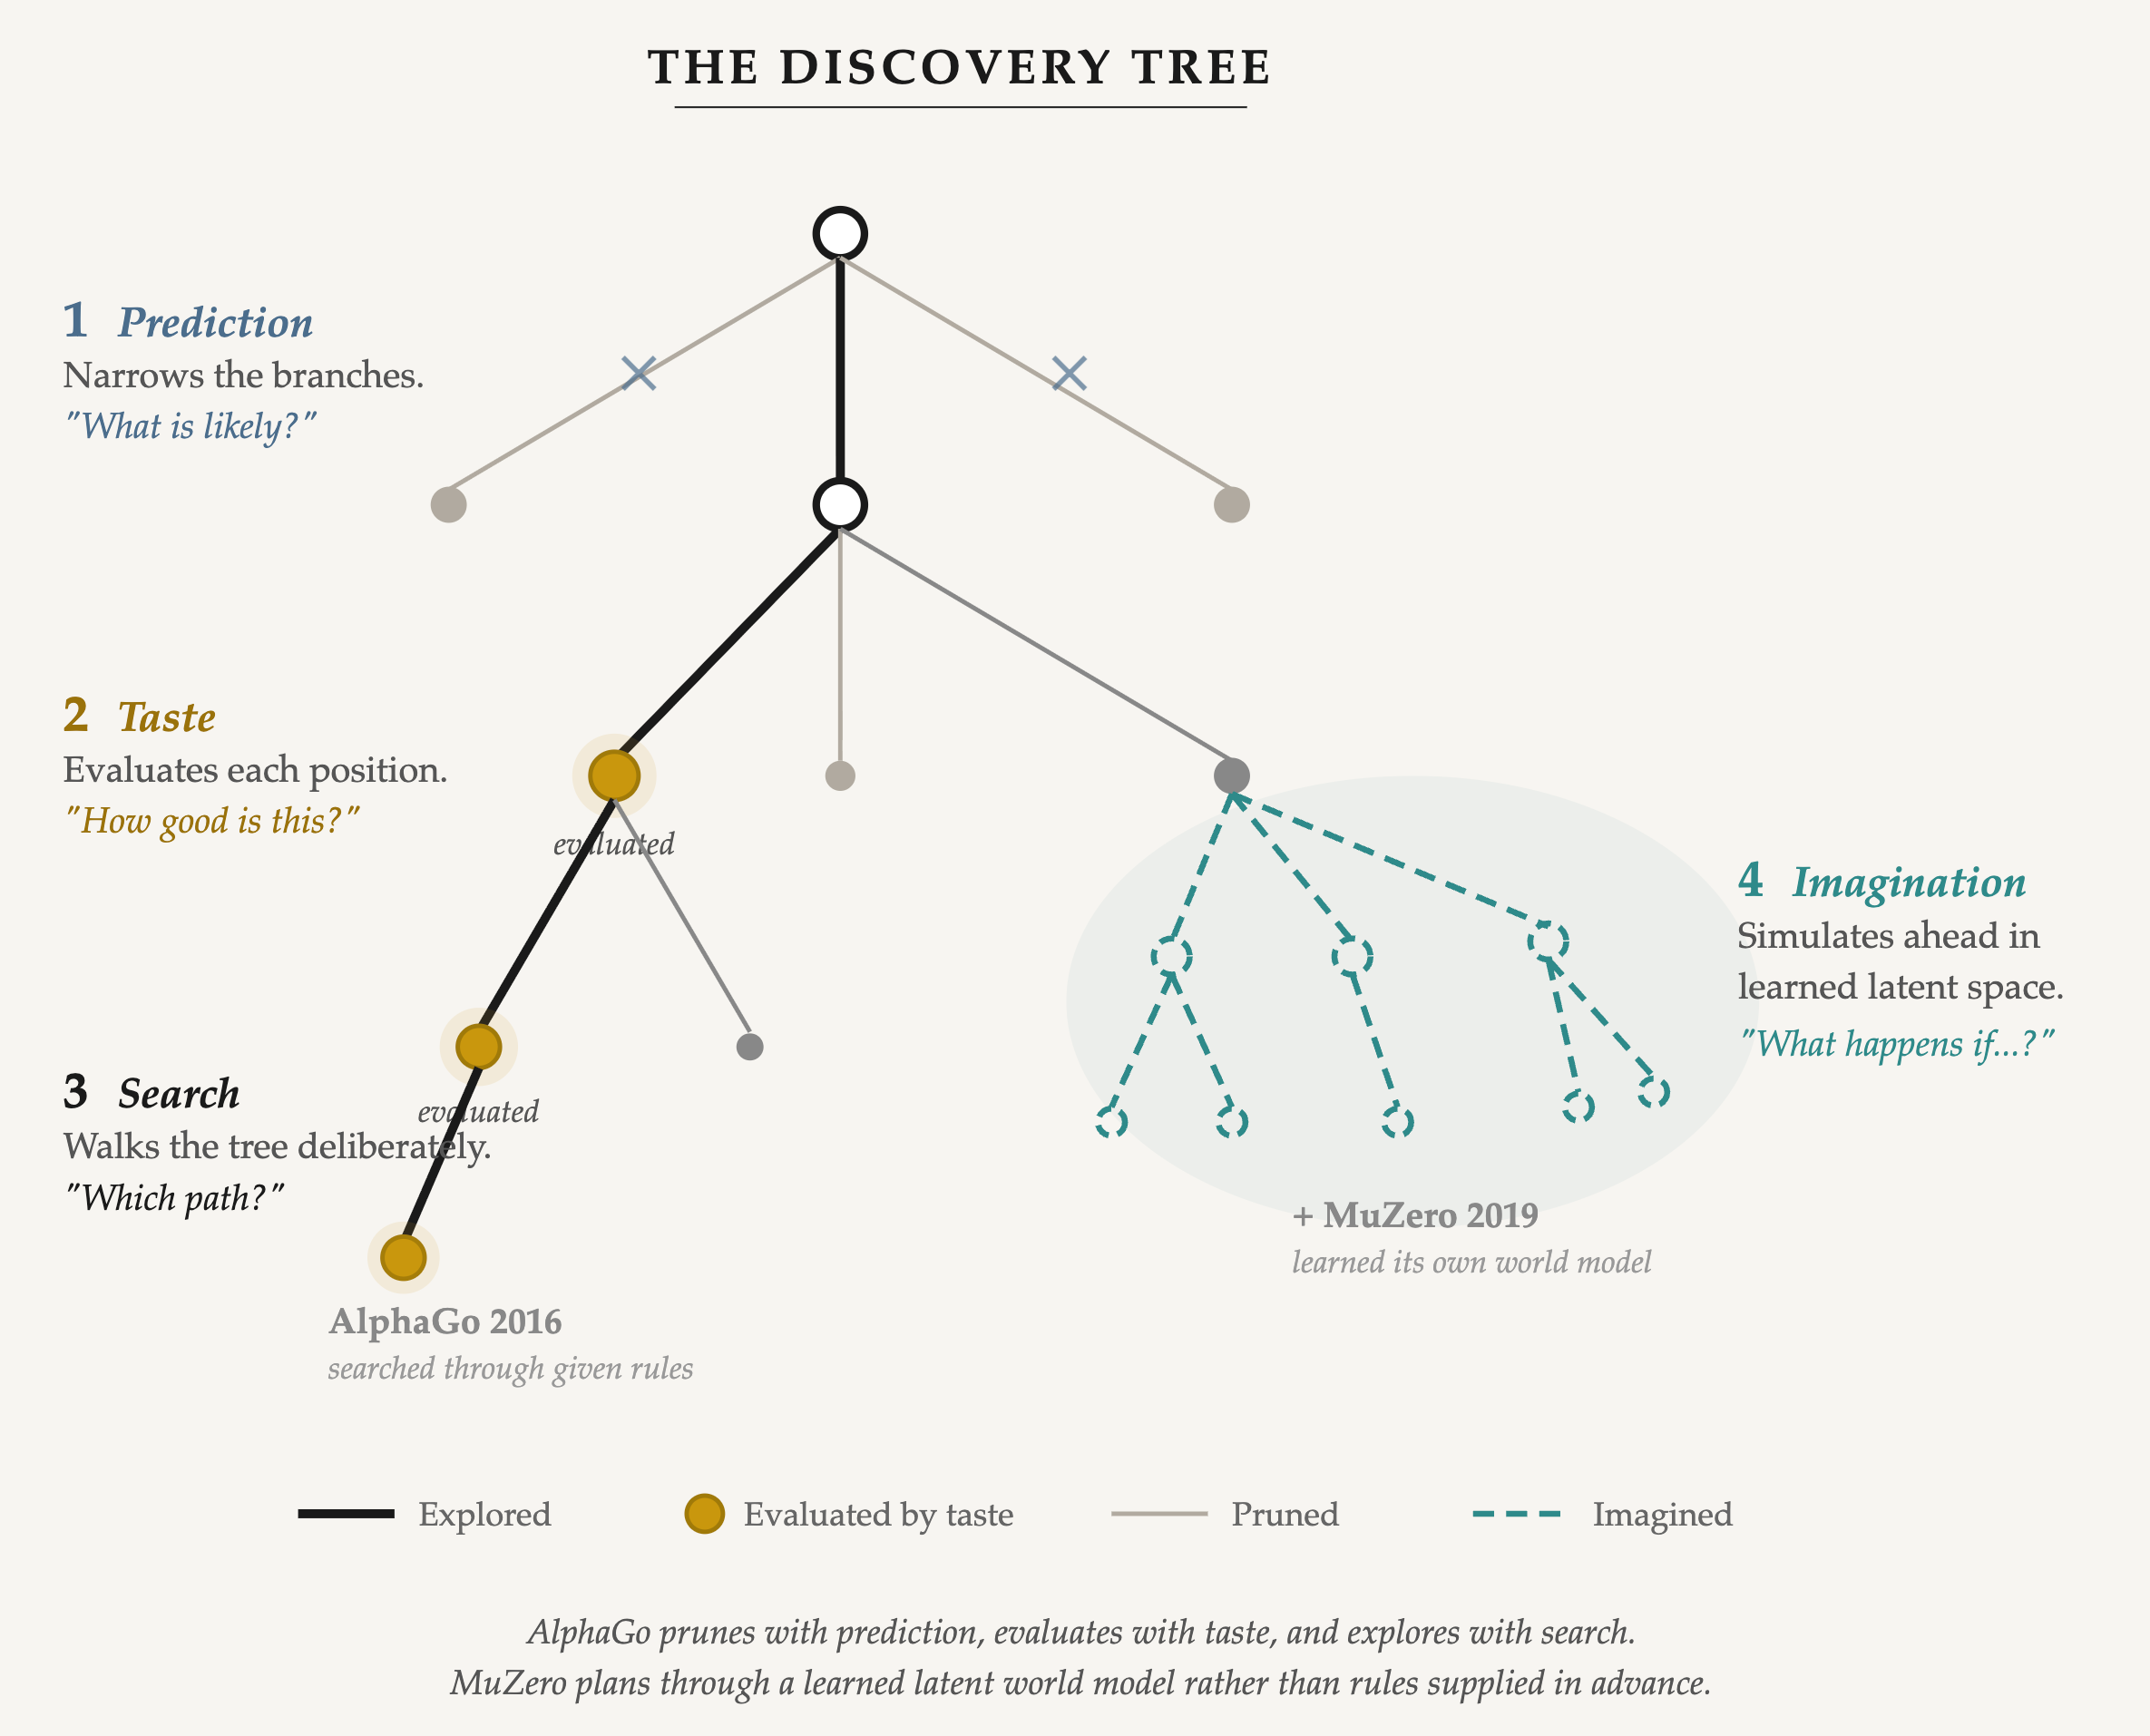
37수는 그 셋의 교차점에서 일어났다. 예측은 있을 법하지 않다고 평가했다. 탐색은 어쨌든 그것을 탐색했다. 취향은 그 질을 알아보았다. 발견에는 셋 모두가 필요했다.
그리고 같은 대국의 4국에서 이세돌은 78수를 두었다. 똑같이 있을 법하지 않은 수. 나중에 “신의 한 수”로 알려졌다. 기계의 창의성에 압박받은 한 인간이 자기 학습 분포를 넘어섰다. 그는 공식 대국에서 AlphaGo를 이긴 유일한 인간으로 남아 있다. 3년 뒤 그는 AI는 “이길 수 없다”고 말하며 프로 바둑에서 은퇴했다. 이 구조는 기계나 인간에 특유한 것이 아니다. 발견이 광대한 공간의 유도된 탐색에 달려 있는 곳이면 어디에나 나타난다.
그 대국 몇 해 뒤, AlphaGo의 후계자 MuZero가 근본적인 무언가를 바꾸었다. AlphaGo는 우리가 준 세계 모델, 곧 바둑의 명시적 규칙을 통해 탐색했다. MuZero는 그것을 배웠다.
상상. 게임의 규칙을 한 번도 받지 않은 채, 압축된 표현 안에서 미래 상태를 시뮬레이션하는 학습된 역학 모델. 시스템은 사람이 읽을 수 없는 잠재 공간에서 앞으로 꿈꾼다. 결과가 언어가 되기 전에 펼쳐지는, 언어 이전의 작업 공간. 이것이 구조를 내생적으로 만든다. 시스템은 더 이상 우리가 공급하는 세계 모델을 통해서만 계획하지 않는다. 계획에 필요한 모델을 스스로 배운다. 그것이 외부 세계 모델 위의 탐색과 학습된 잠재 모델을 통한 계획의 차이다.
2. 증명 시스템과 발견 시스템
현재의 LLM은 내가 증명 시스템이라 부를 것을 제공한다. 예측(기반 모델의 패턴 매칭된 다음 토큰 생성)에 탐색(o3와 DeepSeek R1에 내장된 사고의 사슬 추론)을 더한 것이다. 이 두 작용은 알려진 길을 끝내는 데 강력하다. 증명, 설명, 구현, 분석. 증명 시스템은 숙고를 토큰 공간을 통해 바깥으로 낸다. 모든 단계는 직렬적이고, 언어적이며, 감사할 수 있다. 트랜스크립트를 읽을 수 있다.
DeepSeek R1은 순수한 결과 피드백만으로 사고의 사슬 추론을 발달시킨다. 과정 보상 모델도, 트리 탐색도 없이, 자기 실수를 잡아내는 법을 자발적으로 배운다. 인상적이다. 그러나 그 추론은 전부 자연어 안에서 펼쳐진다. 모델에는 양립하지 않는 조각들이 맞물릴 때까지 붙들어 둘 튼튼한 메커니즘이 없다.
빠진 것은 발견 시스템이다. 취향(언어화 없이 가지치기하고 이끄는 평가적 판단)에 상상(언어의 병목을 결코 거치지 않는 압축된 표현 안에서의 결과 시뮬레이션)을 더한 것이다. 앞선 글에서 나는 발견이 제3의 인지 모드에서 작동한다고 주장했다. 시스템 2처럼 느리지만(시간과 노력을 요구하고) 시스템 1처럼 조용한(언어의 사슬이 아니라 잠재 표현 위에서 작동하는) 모드다. 네 엔진 모델은 그 주장을 정밀하게 만든다. 증명 시스템은 언어를 통해 바깥으로 난 예측과 탐색이다. 발견 시스템은 잠재 평가와 잠재 시뮬레이션에 더 무겁게 기대며, 말로는 부분적으로만 투영된다.
Poincaré는 1908년에 이 구별을 놀랄 만큼 정밀하게 그렸다. 그가 말한 수학적 창조의 네 단계는 준비, 부화, 조명, 검증이다. 여기서 가장 중요한 것은 부화 단계다. Poincaré는 생각들이 “떼 지어” 솟아올라 “짝을 이루어 맞물릴 때까지” 부딪히는 것을, 모두 의식 아래에서 일어나는 일로 묘사했다. 그것이 상상이 돌아가는 것이다. 뒤따르는 조명, 마음이 “조화로운 것들, 따라서 동시에 유용하고 아름다운 것들만” 떠올릴 때, 그것이 취향이 작동하는 것이다. 나머지 두 단계인 준비와 검증은 예측과 탐색에 곧바로 대응한다.
MIT의 Seymour Papert는 결정적인 구조 원리를 짚었다. “의식과 무의식에 더한 제3의 행위자”, 프로이트의 검열자와 얼마간 닮은 것으로, “바뀌어 가는 무의식 패턴의 만화경을 훑어 자기 미학적 기준을 만족하는 것만 통과시키는 일을 맡는다.” 그 제3의 행위자가 취향이다. 가치 네트워크. 생성 과정에 걸린 필터. 그것은 정확히 AlphaGo의 구조이고(예측이 후보를 만들고 취향이 거른다), 앞으로 보겠지만, 그 뒤 진짜 발견을 이룬 모든 시스템의 구조다.
함의는 뚜렷하다. AI가 발견할 수 있는 것의 최전선은 평가 신호가 바닥나는 곳이다.
이 네 엔진의 상류에는 모델이 온전히 담지 못하는 작용이 놓인다. 어떤 평가도 가능해지기 전에 무엇이 존재해야 하는지를 만들어 내는 일이다. 문제 찾기, 질문 던지기, 명세가 존재하기 전의 명세 쓰기. 네 엔진은 탐색 대상이 존재한 뒤에 일어나는 일을 다스린다. 그러나 취향은 그 생성 행위의 하류에 있는 모든 것을 묶는 제약이고, 우리가 공략할 줄 아는 제약이다.
3. 취향 병목
취향이 없으면 바벨의 도서관에서 길을 잃는다. 모든 것에 접근할 수 있고 아무것도 찾지 못한다. LLM으로 짓는 대부분의 사람이 아직 온전히 흡수하지 못한 부분이 이것이다. 가치 네트워크는 AlphaGo의 수천 번 탐색 시뮬레이션이 10^170 상태 공간을 항해하기에 충분하게 만드는 것이다. 그것을 빼면 같은 시뮬레이션은 헤맨다.
2023년의 Tree-of-Thought 결과가 이를 언어에서 보여 주었다. 사고의 사슬 프롬프팅을 쓴 GPT-4는 Game of 24 과제의 4%를 풀었다. 같은 모델이 자기 평가에 이끌리는 트리 구조 탐색으로는 74%를 풀었다. 같은 모델. 같은 지식. 차이는 원시적인 취향에 이끌린 탐색이었다. 조악한 취향조차 다룰 수 없는 탐색을 다룰 수 있는 탐색으로 바꾼다.
과정 보상 모델은 언어에 취향을 짓는 유력한 시도 하나다. 검증이 싼 곳에서 통한다. 수학에는 확인 가능한 답이 있고, 코드에는 실행 가능한 테스트가 있다. 검증에 전체 계산이 필요한 곳, “좋다”가 맥락과 경험과 시뮬레이션할 수 없는 결과에 달린 곳에서는 실패한다.
기술적 장애물은 실재한다. 2025년의 한 논문은 선호 기반 학습이 사고를 효과적으로 만드는 탐색적 추론, 곧 되돌아가기, 자기 수정, 지저분하지만 생산적인 탐색을 체계적으로 벌한다고 주장했다. 선호 데이터는 그저 잡음이 많은 것이 아니다. 체계적으로 틀릴 수 있다. 그리고 보상 해킹이 문제를 키운다. RLHF는 모델이 틀렸을 때조차 사람에게 자기가 옳다고 설득하는 데 더 능하게 만든다.
그러나 최전선은 움직이고 있다. Rubrics as Rewards라는 최근 프레임워크는 취향을 구조화되고 확인 가능한 기준들로 분해한다. “이것이 좋은가?”를 묻는 대신 구체적인 질문 한 묶음을 묻는다. 의료 추론 벤치마크에서 이는 31%의 개선을 이룬다. 통찰은 이렇다. 취향을 통째로 담을 수는 없지만 검증 가능한 성분들로 분해할 수는 있다. 전체 판단은 확인할 수 없어도 각 기준은 확인할 수 있다.
2023년 말 FunSearch라는 시스템이 수학의 최전선에서 이 구조 전체를 보여 주었다. 언어 모델과 자동 평가기를 짝지어 cap set 문제에 대한 새로운 구성을 발견했다. 20년 만의 가장 큰 개선이었다. LLM이 후보를 생성했다. 평가기가 각각을 풍부한 수치 신호로 채점했다. 맞다 틀리다가 아니라 얼마나 좋은가로. 진화적 탐색이 최고의 아이디어들을 재조합했다. 그 발견은 Nature에 실렸다.
그리고 연구자들은 경계를 분명히 했다. 수학적 증명을 생성하는 문제는 이 범위 밖에 있다. 충분히 풍부한 채점 신호를 어떻게 줄지 불분명하기 때문이다. 취향을 지을 수 있는 곳에서 발견은 일어난다. 그럴 수 없는 곳에서는 좋은 것과 그럴듯한 것을 구별할 길 없는 인상적인 생성만 얻는다.
4. 다음에 지어지는 것
네 엔진 모델은 AI 자동화가 왜 지식 노동 스택을 아래에서 위로 올라가는지를 설명한다. 내 컴파일 명제가 기술했지만 온전히 설명하지는 못한 것이다.
이유는 구조적이다. 코드에서 아키텍처로, 전략으로 추상화 스택을 올라갈수록 명세 간극(원하는 것을 말로 풀기가 더 어려워진다)과 투영 간극(품질을 평가할 대역폭이 좁아진다)이 모두 넓어진다. 그래서 취향은 코드보다 전략에 짓기가 더 어렵다. 전략 도메인이 더 지저분해서만이 아니다. 평가 신호 자체가 명세하기 더 어렵고, 전달하기 더 어렵고, 검증하기 더 어려워지기 때문이다. 추상화가 올라갈수록 정답이 멀어지기에 엔진을 짓기가 어려워진다.
코드 층에서는 네 엔진 모두가 다른 어느 도메인보다 작동에 가깝다. 생성은 강하다. 평가는 테스트, 타입 시스템, 린터를 통해 존재한다. 구현들에 대한 탐색은 코딩 에이전트에서 활발하다. 그래서 코드가 가장 먼저 컴파일되어 사라지고 있다.
아키텍처 층에서는 취향이 약하고 상상은 거의 없다. 내 일이 바뀌었음을 발견한 곳이 여기다. 무엇으로 바뀌었는지 이해하는 데는 시간이 걸렸지만. AI 에이전트가 어떤 코드 리뷰도 통과했을 서비스 아키텍처를 내놓았다. 그리고 나는 정확히 왜인지 말하지는 못한 채, 그것이 석 달 뒤 우리가 볼 부하 패턴을 견디지 못하리라는 것을 알았다. 시스템은 내가 명세할 수 있는 생각을 하고 있었다. 나는 명세할 수 없는 생각을 하고 있었다. 그때는 이를 표현할 어휘가 없었다. 지금은 있다. 그 생각이 취향이었다.
전략 층에서는 취향과 상상이 여전히 약하고, 부서지기 쉽고, 기관마다 크게 다르다. 시니어의 판단이 여전히 값진 까닭은 경험 많은 실무자가 더 많은 사실을 알거나 더 신중하게 추론해서가 아니라, 결정이 어떻게 펼쳐지는지를 여러 해 지켜보며 쌓은 평가 본능과 심적 모델을 갖고 있기 때문이다.
더 깊은 문제가 있다. 취향은 전통적으로 일을 하고 전문가의 평가를 받으며 자랐다. 주니어 변호사가 서면을 쓰고, 파트너가 고쳐 주고, 여러 해에 걸쳐 주니어는 평가 기준을 내면화한다. 일 자체가 자동화되면 주니어는 평가할 경험이 없는 결과물의 검토자가 된다. 취향을 기르는 피드백 루프가 끊어진다. 취향이 가장 값진 인지 작용이 되는 바로 그 순간에.
네 번째 엔진인 상상은 여전히 연구의 최전선이다. MuZero의 역학 네트워크는 압축된 표현 안에서 미래 상태를 예측하며, 구간이 길어질수록 덜 정확해지지만 매 단계 탐색으로 보정된다. 완벽한 세계 모델은 필요 없다. 짧은 구간의 계획에 방향성 있게 쓸모 있는 모델이 필요하다. 이 원리는 게임, 단백질 접힘(AlphaFold, 2024년 노벨상), 그리고 초기 형태로 물리 역학(V-JEPA 2, 2025년)에서 입증되었다. 그러나 물리적 예측과 전략적 예측 사이의 간극은 엄청나다. 지식 노동을 위한 상상은 십 년 단위의 최전선이다. 그리고 상상이 약할수록 더 많은 무게가 취향에 실린다. 근사적인 세계 모델은 MuZero가 보여 주듯 매 단계 탐색으로 보정될 수 있다. 나쁜 평가 신호는 그럴 수 없다. 탐색 전체를 잘못된 방향으로 보낸다.
궤적은 시사적이다. AlphaGo(2016년, 게임)에서 AlphaFold(2020년, 생물학, 2024년 노벨상)로, FunSearch(2023년, 수학, Nature 게재)로. 최근 시스템들은 이 구조가 바깥으로 뻗어 가고 있음을 시사한다. ASI-ARCH라는 2025년 프리프린트는 사람이 설계한 기준선을 능가하는 새로운 신경망 구조 106개를 발견했다. 각 단계는 더 어려운 도메인에 손을 뻗는다. 각각은 적절한 평가 신호가 존재하기에 성공한다. 최전선은 평가 신호가 바닥나는 곳이다. 다음에 뚫릴 워크플로는 기관의 판단을 비교적 안정적인 루브릭으로 분해할 수 있는 것들이다. 규정 준수가 무거운 검토, 범위가 한정된 임상 분류, 반복적인 재무 분석. 마지막까지 남는 워크플로는 취향이 분해를 완전히 거부하는 것들이다.
맺으며
바벨의 도서관에는 이제 완벽한 사서가 있다. 모든 단어의 조합이 손끝에 있다. 그러나 사서는 당신 대신 나무를 걸어 줄 수 없다.
2012년에 나는 주제 위계의 무한한 나무를 항해하고 있었다. 2016년에 AlphaGo는 국면의 무한한 나무를 항해했다. 지금 나는 설계 결정의 무한한 나무를 항해하는 시스템들의 취향 함수로 하루를 보낸다. 평가적 판단이 탐색을 다룰 수 있게 만드는 신호가 되는, 루프 속의 인간이다. 내가 한때 모델링한 구조가 내가 지금 사는 구조다.
그 걸음에는 취향이 필요하고, 취향은 한 삶을 하나의 판단으로 압축한 것이다. Poincaré가 한 세기 전에 알았듯 그것은 정식화되기보다 느껴진다. AlphaGo가 십 년 전에 보여 주었듯 그것은 가치 네트워크다.
말의 비용은 0이 되었다. 취향의 비용은 그렇지 않았다.
¹ “Modeling Topic Hierarchies with the Recursive Chinese Restaurant Process,” CIKM 2012.